
Читать полный материал
ZFS — файловая система с управлением хранилищем, mdadm — средство управления массивами Linux MD, а аппаратный RAID передаёт эту роль контроллеру. Выбор зависит от приложения, требований к целостности данных и модели эксплуатации.
Общий гайд по выбору СХД помогает определить архитектуру. Здесь сравним три подхода к организации локального массива и их место в сервере хранения.
Что разобрано в статье
Архитектура
Кто управляет дисками и данными
Linux MD
Массив и отдельная файловая система
ZFS
Пул, vdev и контрольные суммы
Платформы
TrueNAS и Proxmox VE
Подключение
HBA, SATA и прямой NVMe
Эксплуатация
Память, копии и восстановление
Сначала выберите владельца дисков и данных
ZFS, mdadm и аппаратный RAID решают связанные, но разные задачи. mdadm управляет массивами Linux MD, поверх которых обычно размещают файловую систему. ZFS объединяет управление хранилищем и файловую систему: диски входят в виртуальные устройства vdev, из которых складывается пул. Аппаратный RAID переносит управление массивом в контроллер, а операционной системе предоставляет логические устройства.
Поэтому сравнивать только названия уровней RAID недостаточно. Нужно определить, кто видит физические накопители, хранит метаданные массива, обнаруживает ошибки, управляет восстановлением и сообщает администратору об отказе. От этого зависят диагностика, перенос дисков, совместимость и процедура аварийного восстановления.
Статья сравнивает выбор стека хранения для нового проекта. Если вопрос сводится к роли адаптера и его режиму, начните с материала HBA и RAID: различия архитектуры подключения. Здесь адаптер рассматривается как часть выбранного стека, а не как самостоятельный победитель сравнения.
RAID любого типа не заменяет резервную копию. Ошибочная запись, удаление, компрометация учётной записи и потеря всей площадки могут затронуть данные независимо от числа исправных дисков. До выбора реализации определите допустимую потерю данных, время восстановления и отдельное место хранения копий.
mdadm: массив Linux и отдельно выбранная файловая система
mdadm подходит для построения и обслуживания массивов Linux MD, когда команда эксплуатации использует стандартный Linux и осознанно выбирает файловую систему, мониторинг и резервное копирование. Типичный проект разделяет эти уровни: MD предоставляет блочное устройство, а файловая система отвечает за структуру файлов и свои механизмы согласованности.
Такой подход удобен, если нужны понятная интеграция с существующим Linux, знакомые средства наблюдения и отсутствие зависимости от конкретного RAID-контроллера. Однако переносимость не означает, что достаточно переставить диски в произвольный сервер. Нужно проверить поддержку метаданных, загрузку системы, идентификаторы устройств, версии программ и доступность ключей шифрования.
Нельзя приписывать mdadm все возможности ZFS: наличие избыточности массива само по себе не создаёт сквозных контрольных сумм пользовательских данных, снапшотов или репликации файловой системы. Эти свойства зависят от дополнительных слоёв. И обратное утверждение «Linux RAID никак не защищён от незавершённой записи» тоже слишком широкое: документация MD описывает журнал и механизмы согласованности для конкретных уровней и конфигураций.
Для эксплуатации заранее назначают получателя уведомлений, контролируют состояние массива и накопителей, планируют замену диска и проверяют восстановление из копии. Фраза «программный RAID бесплатный» не описывает стоимость поддержки: обслуживание Linux, диагностика и аварийные работы остаются задачей владельца системы.
ZFS и RAIDZ: пул, контрольные суммы и восстановление
ZFS хранит контрольные суммы данных и метаданных и проверяет прочитанные блоки. Это позволяет обнаруживать повреждение, которое не сводится к полному отказу накопителя. Если в доступной конфигурации есть корректная избыточная копия, ZFS может использовать её для восстановления. Само наличие контрольной суммы не создаёт второй экземпляр данных.
Уровень отказоустойчивости задают при проектировании vdev: например, выбирают зеркала либо RAIDZ с нужным числом блоков чётности. Пул не становится защищённым только от того, что в нём много накопителей. Потеря необходимого vdev способна сделать недоступным весь пул; добавление отдельного незащищённого vdev нельзя считать безопасным расширением существующей избыточности.
Снапшоты фиксируют состояние наборов данных и полезны для возврата к предыдущей версии. Но снимок в том же пуле зависит от сохранности этого пула. Для защиты от его потери требуется независимая копия или репликация с подходящей политикой хранения и проверкой восстановления. Права на удаление снимков и доступ к реплике также входят в модель защиты.
Периодический scrub проверяет сохранённые блоки и помогает обнаруживать повреждения, но создаёт нагрузку. Расписание, запас производительности и реакцию на ошибки определяют заранее. Нельзя обещать, что RAIDZ всегда быстрее зеркал или всегда медленнее контроллера: результат зависит от состава пула, блоков, синхронности записи и рабочей нагрузки.
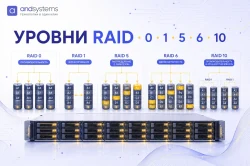
Различия уровней избыточности подробно разобраны в статье уровни RAID для хранилища. В проекте ZFS дополнительно учитывают устройство vdev, распределение данных и возможности именно установленной версии OpenZFS.
TrueNAS и Proxmox: ZFS внутри поддерживаемой платформы
TrueNAS предлагает управление хранилищем на базе ZFS, а Proxmox VE использует ZFS как один из вариантов локального хранения виртуальных машин. Это разные роли платформ. Выбор TrueNAS для файловых служб не означает автоматически, что такую же конфигурацию нужно повторить на узле виртуализации.
Сначала определяют границу ответственности: где работают приложения, кто предоставляет файловый или блочный доступ, где находятся резервные копии и что происходит при отказе узла. Для сервера виртуализации полезен отдельный разбор требований Proxmox VE и VMware ESXi. Наличие ZFS не создаёт само по себе кластерную доступность или автоматический перезапуск виртуальных машин на другом сервере.
Документация Proxmox предупреждает о сочетании ZFS с аппаратным RAID-контроллером, управляющим собственным кэшем. Практический вывод — проектировать прямой доступ ZFS к накопителям и проверять поддерживаемую схему подключения. Это не универсальный запрет использовать в одном сервере любое устройство, на корпусе которого написано RAID: решающими являются его реальный режим, кэширование и видимость дисков.
TrueNAS также требует внимательно выбирать контроллеры и дисковую подсистему. Перед закупкой сверяют документацию актуального выпуска, поддержку адаптера и драйвера, видимость серийных номеров и ошибок, порядок замены накопителей. Возможности одной версии платформы нельзя без проверки переносить на все её прошлые и будущие выпуски.
Прямой доступ к дискам: HBA, SATA или NVMe
ZFS должна получать достоверное представление о накопителях и управлять избыточностью на своём уровне. Для SAS/SATA-полки обычно рассматривают подходящий HBA в режиме прямого доступа. В других системах применяются поддерживаемые встроенные SATA-порты или прямое подключение NVMe. Требование «для ZFS всегда нужно купить отдельный HBA» неверно.
Один логический RAID-том, скрывающий несколько дисков, мешает ZFS видеть исходную топологию и самостоятельно управлять её восстановлением. Создание отдельного RAID0 на каждый диск тоже нельзя автоматически приравнять к полноценному прямому доступу: остаются особенности прошивки, кэширования, обработки ошибок и переноса накопителей.
При подборе адаптера главной шины проверяют интерфейс, число линий, прошивку и поддержку платформой. Также учитывают кабели, backplane, экспандеры, число дисков и реальную пропускную способность соединения. Формальное совпадение разъёма не подтверждает совместимость всей цепочки.
У аппаратного RAID другой договор: дисками и массивом управляет контроллер. При выборе RAID-контроллера важны поддерживаемые накопители, средства наблюдения и процедура замены адаптера. Отдельно проверяют режимы write-back и защиту кэша; защита кэша контроллера и защита питания самого SSD — разные свойства.
Память и ECC: закладывайте ресурс под всю систему
ZFS использует оперативную память для кэширования и служебных структур. Память нужна также операционной системе, файловым службам и приложениям; на гипервизоре — ещё и гостевым машинам. Требования нельзя получать единственной формулой от числа терабайт дисков, игнорируя эти потребители и профиль операций.
Рекомендация ECC уместна для сервера хранения: коррекция ошибок памяти снижает один из рисков для системы. Однако ECC не заменяет дисковую избыточность, копии и проверку восстановления. Наличие обычной памяти само по себе не означает, что ZFS технически не запустится, а наличие ECC не гарантирует сохранность данных при любой неисправности.
Совместимость модулей, процессора и платы проверяют отдельно; о различиях типов памяти рассказывает материал ECC, RDIMM, LRDIMM и UDIMM. Поддержка ECC определяется платформой целиком, а не надписью на одном модуле.
Не стоит включать дедупликацию только потому, что она есть в интерфейсе. Её польза и затраты зависят от повторяемости данных и реализации. Аналогично дополнительный SSD не является универсальным ускорителем: read cache, журнал синхронных записей и основной пул выполняют разные задачи. Конфигурацию выбирают по измеренному узкому месту.
Сравнение: что входит в выбранный стек
| Критерий | ZFS | mdadm / MD | Аппаратный RAID |
|---|---|---|---|
| Уровень управления | Пул и файловая система | Блочный массив Linux MD | Массив в контроллере |
| Файловая система | ZFS | Выбирается отдельно | Выбирается в ОС |
| Целостность | Контрольные суммы; ремонт при доступной корректной копии | Зависит от массива и верхних слоёв | Зависит от контроллера и верхних слоёв |
| Диски | Прямой доступ и поддерживаемая топология | Поддерживаемый доступ Linux к накопителям | Поддерживаемые контроллером диски |
| Эксплуатация | Пулы, vdev, scrub, снимки и копии | MD, файловая система, мониторинг и копии | Прошивка, кэш, мониторинг и копии |
Эта таблица описывает распределение функций, а не рейтинг надёжности. В каждой колонке возможны удачные и неудачные проекты. Аппаратный RAID может быть оправдан требованиями платформы и действующей поддержки; mdadm — существующей эксплуатацией Linux; ZFS — потребностью в интегрированных механизмах целостности и управления наборами данных.
Производительность проверяют на одинаковой прикладной задаче: размер операций, случайный или последовательный доступ, доля записи, синхронность и число клиентов. Для базы данных и каталога резервных копий один и тот же синтетический показатель не описывает полезную работу. В тест включают рабочие требования к сохранности записи и защите обмена.
Нужен запас и на деградированный режим: восстановление массива, scrub, резервное копирование и обычные запросы могут конкурировать за ресурсы. Приёмка должна описывать допустимое время ответа и восстановление после отказа, а не только максимальную скорость исправного пустого массива.
Как принять решение и что передать для подбора
Начните с приложения и модели восстановления. Для готовой поддерживаемой серверной конфигурации с проверенным контроллером может быть разумно сохранить аппаратный RAID. Если команда обслуживает Linux и ей нужен отдельный блочный массив под выбранную файловую систему, рассмотрите mdadm. Если нужны свойства ZFS, выбирайте поддерживаемую платформу и прямой доступ к дискам, не пряча их за дополнительным массивом.
Для подбора подготовьте полезный объём, рост данных, число клиентов, профиль операций, требования к времени восстановления, схему копий и ограничения по платформе. Укажите существующие диски, адаптеры, корпус и backplane. Это позволит сравнить законченные конфигурации, а не только стоимость платы контроллера.
Затем согласуйте порядок наблюдения и ремонта: кто получает сигнал об ошибке, как определяется нужный диск, где хранится запасной накопитель и как проверяют восстановление. Документированный сценарий отказа полезнее обещания «этот RAID не теряет данные». Проверку восстановления проводят на безопасной копии, не экспериментируя с рабочим массивом.
Если требуется готовая система, начните с раздела систем хранения данных и передайте требования специалисту. Статья задаёт критерии выбора; она не подтверждает совместимость конкретной комплектации и не содержит собственных сравнительных испытаний ZFS, mdadm и RAID-контроллеров.
Частые вопросы
ZFS всегда требует отдельного HBA?
Нет. Возможен поддерживаемый прямой доступ через HBA, SATA или NVMe. Важно, чтобы диски не скрывались за дополнительным RAID-томом.
RAIDZ и снапшоты заменяют резервную копию?
Нет. Снимки в том же пуле зависят от его сохранности. Для восстановления после потери пула нужна независимая копия.
mdadm — файловая система?
Нет. mdadm управляет массивами Linux MD; файловая система и её функции выбираются отдельно.
ZFS исправляет любую ошибку диска?
Нет. Контрольная сумма позволяет обнаружить повреждение, а для восстановления нужна доступная корректная избыточная копия.
Без ECC ZFS не работает?
Такого универсального технического запрета нет. ECC рекомендуется для снижения риска ошибок памяти, но не заменяет копии и избыточность.
Что быстрее: ZFS, mdadm или RAID-контроллер?
Универсального ответа нет. Сравнивают законченные конфигурации на одной прикладной нагрузке, включая требуемую сохранность записи и деградированный режим.
Источники и границы сравнения
OpenZFS: контрольные суммы, свойства ZFS; Linux MD и журнал RAID 4/5/6; TrueNAS: требования к оборудованию; Proxmox VE: ZFS и системные требования. Это документация реализаций, а не собственный сравнительный тест трёх стеков.
Авторство и ответственность
Материал сравнивает принципы организации хранения. Он не заменяет проверку совместимости платформы, контроллера и накопителей; собственные испытания производительности не заявлены.
Материал подготовлен при участии AI-ассистента. Технические положения сверены с документацией OpenZFS, Linux MD, TrueNAS и Proxmox; собственные испытания оборудования в статье не заявлены.
Для подбора оборудования и КП: info@andpro.ru, +7 (495) 545-48-70, +7 (800) 707-78-15.
Дата последнего обновления материала: 21 октября 2026.